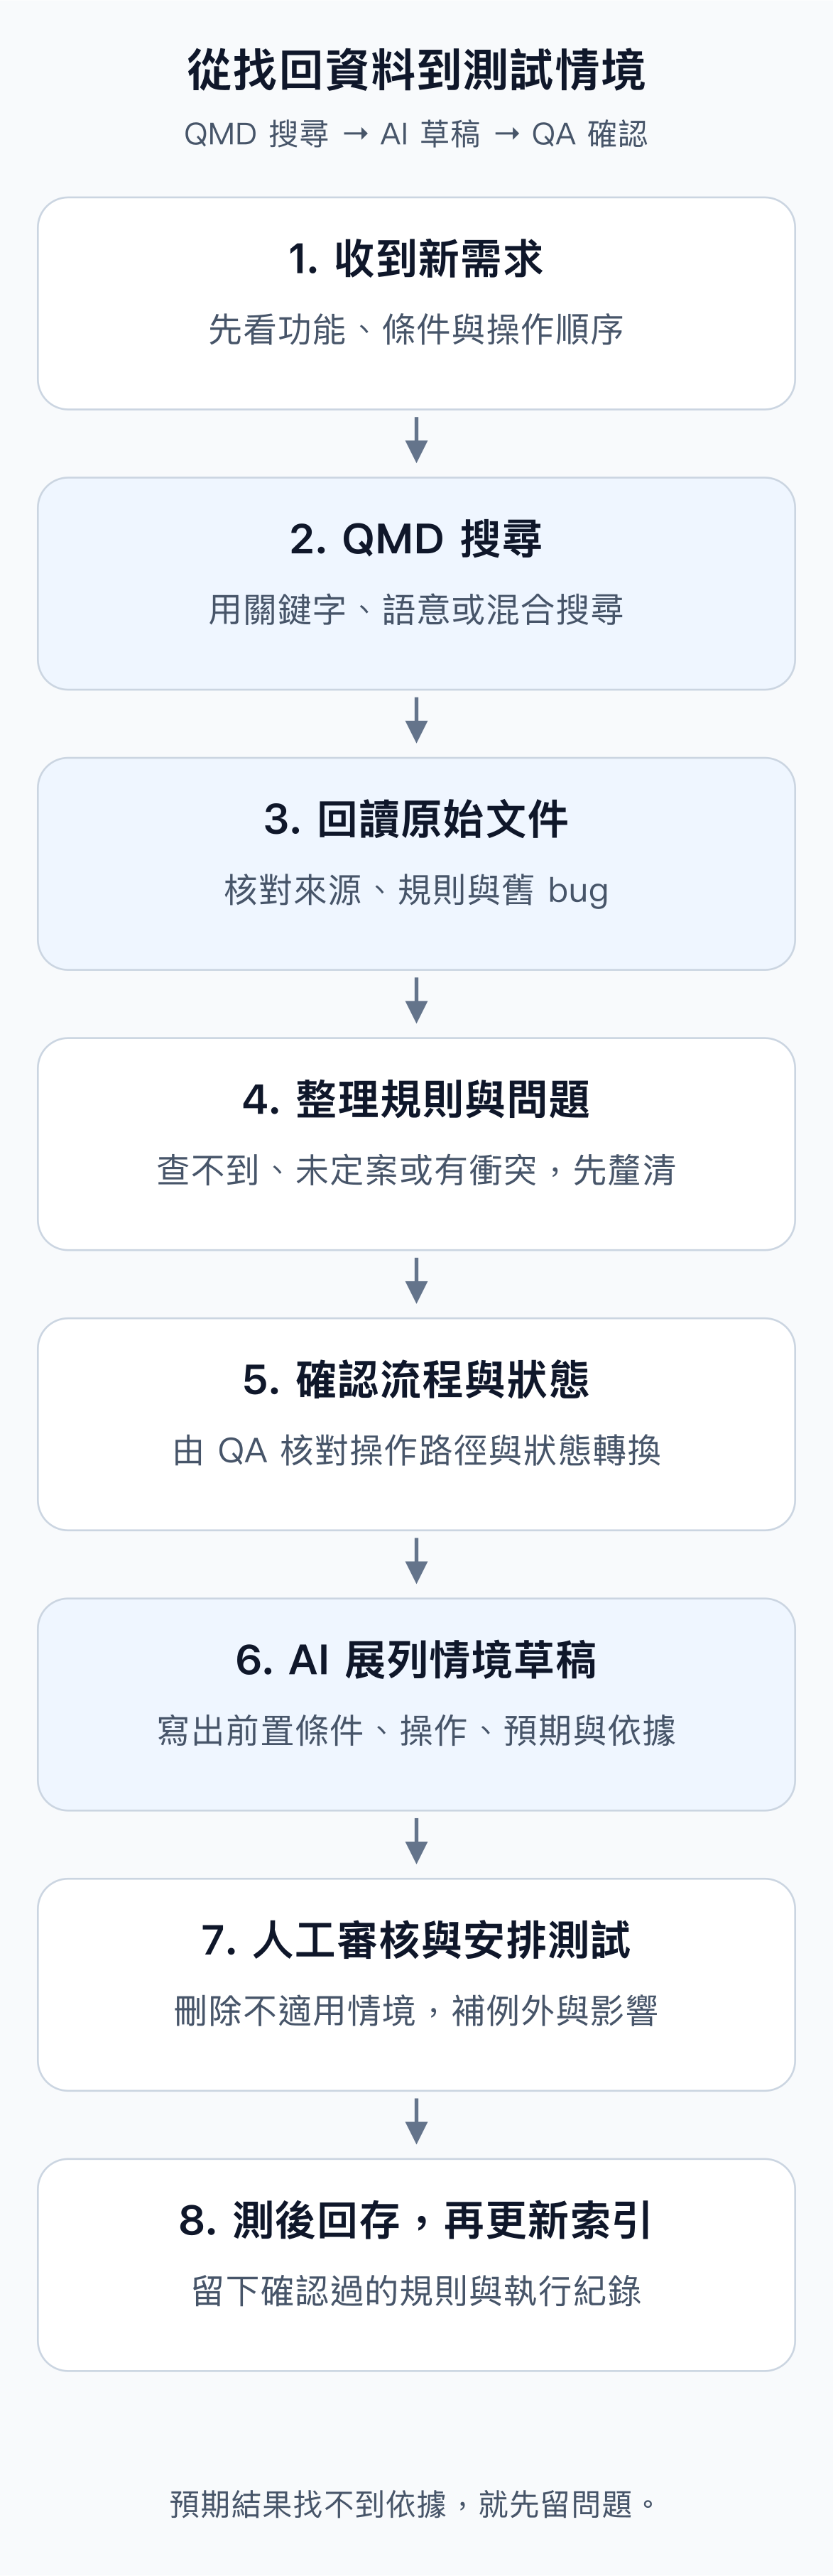
用 QMD 找回 QA 經驗:從 qa_brain 搜尋到測試情境
#QA 知識庫 #QMD #測試設計 #AI
收到新需求,我通常得先翻一輪資料:需求文件、舊 bug、聊天紀錄。找不到就問同事,或自己操作產品、查程式和 log。 最難找的往往是例外。某個條件下才成立的規則、以前那個 bug 怎麼重現、當時影響到哪些功能。產品規則多,有些事明明處理過,再遇到卻只記得一個大概。 所以我開始整理 qa brain,把自己的測試筆記、案例、產品需求和業務規則放進去。後來也把 QMD 接進查詢和展列流程,收到需求後,先找相關資料,再讓 AI 整理測試情境草稿。 QMD 是什麼?先把它想成筆記的搜尋工具 QMD 是一個裝在電腦上的搜尋工具,用來找你存下來的文件。像測試筆記、產品規則、會議紀錄,只要整理成它能讀取的文件並建立索引,就可以透過它搜尋。 例如收到一個優惠功能的需求,我想查以前有沒有處理過類似問題,就可以搜「優惠」,也可以試著問「付款前資格改變會怎樣」。資料收進搜尋範圍後,QMD 會回傳相關文件的路徑與摘要,讓我打開來看。 | 工具或資料 | 在這裡做什麼 | | | | | qa brain | 存放我整理的產品規則、測試筆記與 bug 經驗 | | QMD | 搜尋這些文件,找出可能用得上的內容 | | AI | 根據找到的內容,整理問題與測試情境草稿 | | 我 | 確認資料適不適用、補情境,決定哪些先測 | QMD 有幾種找法。知道文件裡的用詞,就用關鍵字找;只記得意思,可以試語意搜尋;混合搜尋則把不同找法的結果合起來排序。QMD 官方說明 例如文件寫的是「付款頁保留舊資格」,搜尋時卻問「資格變了,畫面為什麼沒更新」,語意搜尋就有機會找出這類相關內容。能不能找到,仍要看文件內容和使用的模型。 一、為什麼用了知識庫,還要接 QMD? 文件整理好了,下一次測試還是得找。尤其需求換了說法,或我只記得問題的大意時,未必一下就能翻到當初那份紀錄。 直接請 AI 展列,我也不放心。我擔心它寫出產品沒有的操作、漏掉既有限制,或列了很多情境,卻沒碰到這次真正要注意的地方。 所以我目前透過固定流程或技能觸發 QMD 搜尋,關鍵字、語意與混合搜尋都有使用。先找出確認過的規則、舊 bug 和既有測試,再交給 AI 整理。 它對我最有幫助的,是更快找回以前寫過的資料,有時也會找到我原本沒想到要查的內容。例如一筆舊 bug,就可能提醒我,這次也有類似的操作順序或狀態變化要檢查。 二、找資料時,我會先看什麼 第一輪通常從功能名稱、需求關鍵字,以及涉及的狀態、條件或使用者行為開始。找不到,就換同義詞、產品用語或舊名稱,或把問題拆小,分開查。 結果出來先看摘要,需要時再讀原文。我會特別確認來源是否可靠、規則有沒有確認過。資料有衝突,就先留下問題,找 PM/RD 釐清。 展列前,我會整理需求與待釐清問題,再畫使用者流程或狀態轉換。我會先看使用者做了什麼、接著做什麼,以及這個過程牽涉哪些功能、身分和權限。 三、實際使用:從兩份 Markdown 開始 從新需求到測後整理,我會照這個順序走: 開啟完整流程圖 下面用兩份虛構的 QA 文件練習,不涉及公司資料。指令依官方文件整理,使用前可用 qmd help 核對安裝版本。安裝與使用說明 1. 安裝工具,準備能搜尋的文件 先準備 Node.js 22 以上的環境,再安裝 QMD。macOS 的 SQLite 環境需求請依官方說明確認。 建立一個練習資料夾: 在 ~/qa brain demo/rules/offer.md 存入以下文字: 再在 ~/qa brain demo/bugs/offer stale state.md 存入: 正式整理自己的文件時,也要記下來源和確認狀態,方便日後回查。範例中的「已確認」只適用這次練習。 2. 把資料夾加入搜尋集合 Collection 可以理解為一組要納入搜尋的文件。 加入集合後,QMD 就會索引這個資料夾。context 用來說明資料用途,status 可以查看集合與索引狀態。 先確認集合有收進文件,再開始搜尋。如果集合名稱已存在,就使用原本的集合,或換一個沒有使用過的名稱。 3. 先用關鍵字找,再視需要用語意或混合搜尋 如果已經知道文件裡可能出現的詞,先用關鍵字搜尋: c qa demo 代表只查這個集合, n 5 代表最多取五筆。 如果只記得問題的意思,可以再試語意搜尋;想結合不同搜尋方式,則使用混合搜尋。這兩種方式需要向量索引,先執行: embed 會建立向量,首次使用相關模型時可能需要下載;這裡的 qmd embed 也會處理目前索引中其他待建立向量的文件,不只 qa demo。若你已經在用 QMD,請先確認現有集合與處理範圍。 | 我現在知道什麼 | 可以先試哪個指令 | | | | | 知道功能名稱或文件用詞 | qmd search:BM25 關鍵字搜尋,不需要 LLM | | 記得概念,想換個說法找 | qmd vsearch:向量語意搜尋 | | 想合併關鍵字與語意候選,再重新排序 | qmd query:混合搜尋 | 這裡示範的是指令,尚未實跑這組查詢。中文搜尋效果要用自己的文件試過,看看哪種問法、哪種模式比較找得到需要的內容。 4. 打開原文,確認搜尋結果能不能拿來用 先看搜尋結果裡的文件路徑、摘要與相關程度,再讀需要核對的原文: 使用自己的資料時,要換成搜尋結果回傳的文件路徑或 docid。分數代表搜尋相關程度,不能拿來判斷規則是否已定案。 5. 把搜尋與回讀接進 AI 工作流程 手動練習時,可以把確認過的原文交給 AI。若使用的代理能執行本機指令,可以讓它先取搜尋結果,再回讀來源。例如: 這條指令會回傳 JSON 格式的搜尋結果。接著讓 AI 回讀原文,可以用這段指示練習: 若使用的 AI 工具支援 MCP,也可以設定它啟動 qmd mcp 來連接 QMD。不同工具的設定方式不同,請依客戶端文件操作。QMD 的 MCP 說明 平常我會透過固定流程或技能執行搜尋。這裡拆開操作,方便先確認每一步的資料有沒有找對。 公司資料交給 AI 前,要確認允許使用的範圍。QMD 在本機搜尋,但如果後面接雲端模型,送出的文件內容仍會離開本機。 6. 文件改了,要更新索引 新增規則或更新 bug 文件後,記得讓搜尋用到新的內容: 前者重新掃描集合,後者補上需要更新的向量。若只做 BM25 搜尋,可先執行 update。這些命令會處理目前索引的集合;若集合設定了更新前的同步命令,update 也會先執行它,既有使用者應先確認設定。 四、找到舊 bug 之後,怎麼展開情境 我遇過找到舊 bug 後,才想到這次功能也可能有類似風險的情況。我要看的是它當初為什麼出問題,以及這次有沒有同樣的條件。 以下產品、規則與 bug 都是為本文設計的虛構教學素材,不是公司實際事故,也不代表已執行的測試結果。 這次需求是「符合資格的使用者,可以使用一次優惠」。範例 bug 提到,付款頁開啟後,資格變了,畫面卻還留著舊狀態。 開頁面時符合資格,按下付款時還符合嗎?沿著這個時間差,可以往下查幾條路徑: | 操作路徑 | 要觀察或釐清的地方 | | | | | 開啟付款頁後,資格發生改變,再繼續付款 | 付款前是否重新檢查資格?這需要先有明確規則 | | 使用者已在其他地方使用優惠,再回到原本頁面 | 原頁面是否更新資格與價格? | | 從符合資格的帳號切換到另一個帳號 | 優惠顯示與付款資料是否對應目前帳號? | | 付款未完成,之後重新進入流程 | 優惠是否仍可用?哪些狀態會消耗資格? | 五、預期結果沒有依據,就先留下問題 「付款失敗後,優惠還能不能用?」範例文件沒有定案,草稿就應該留著這個問題。寫預期結果時,我會把依據分清楚: | 類型 | 在草稿裡怎麼處理 | | | | | 已確認規則 | 依虛構需求,符合資格者可使用一次優惠;以此設計基本流程 | | 風險推論 | 付款頁開啟後,資格可能改變;列出需要檢查的操作路徑 | | 待釐清事項 | 資格在哪個時點判斷?付款失敗是否消耗優惠?先保留問題 | 我會把待確認的問題留在草稿裡,向 PM/RD 問清楚後,再補預期結果、收錄規則。新需求與舊文件有衝突,也要在測試前釐清,才能更新文件。 六、人工審核,主要在刪什麼、補什麼 審 AI 草稿時,有幾種內容我會刪:產品沒有的操作、重複或拆得太細的情境,以及沒有依據的預期結果。 補的時候,我會沿著使用者的操作順序看。同樣是「使用優惠」,從首頁進入、付款中斷後回來、切換帳號後重進,涉及的狀態可能不同。草稿有沒有分清楚?這些路徑在產品裡走得通嗎?再從中找規則衝突、例外與跨功能影響。 測試時間不夠,就先測核心流程、出問題影響最大的地方,再看這次改動範圍和過去容易出事的區域。 七、測完,再把確認過的內容補回去 我通常在功能測完或 bug 結案後整理知識。這次問清楚的規則、測過的情境和執行紀錄,都留給下一次查。 省了多少時間,我沒有量過。找資料和整理草稿確實比較省力,有時也能翻到原本沒想到要查的紀錄。以前處理過的問題,下次拿到新需求時還找得到,才用得上。